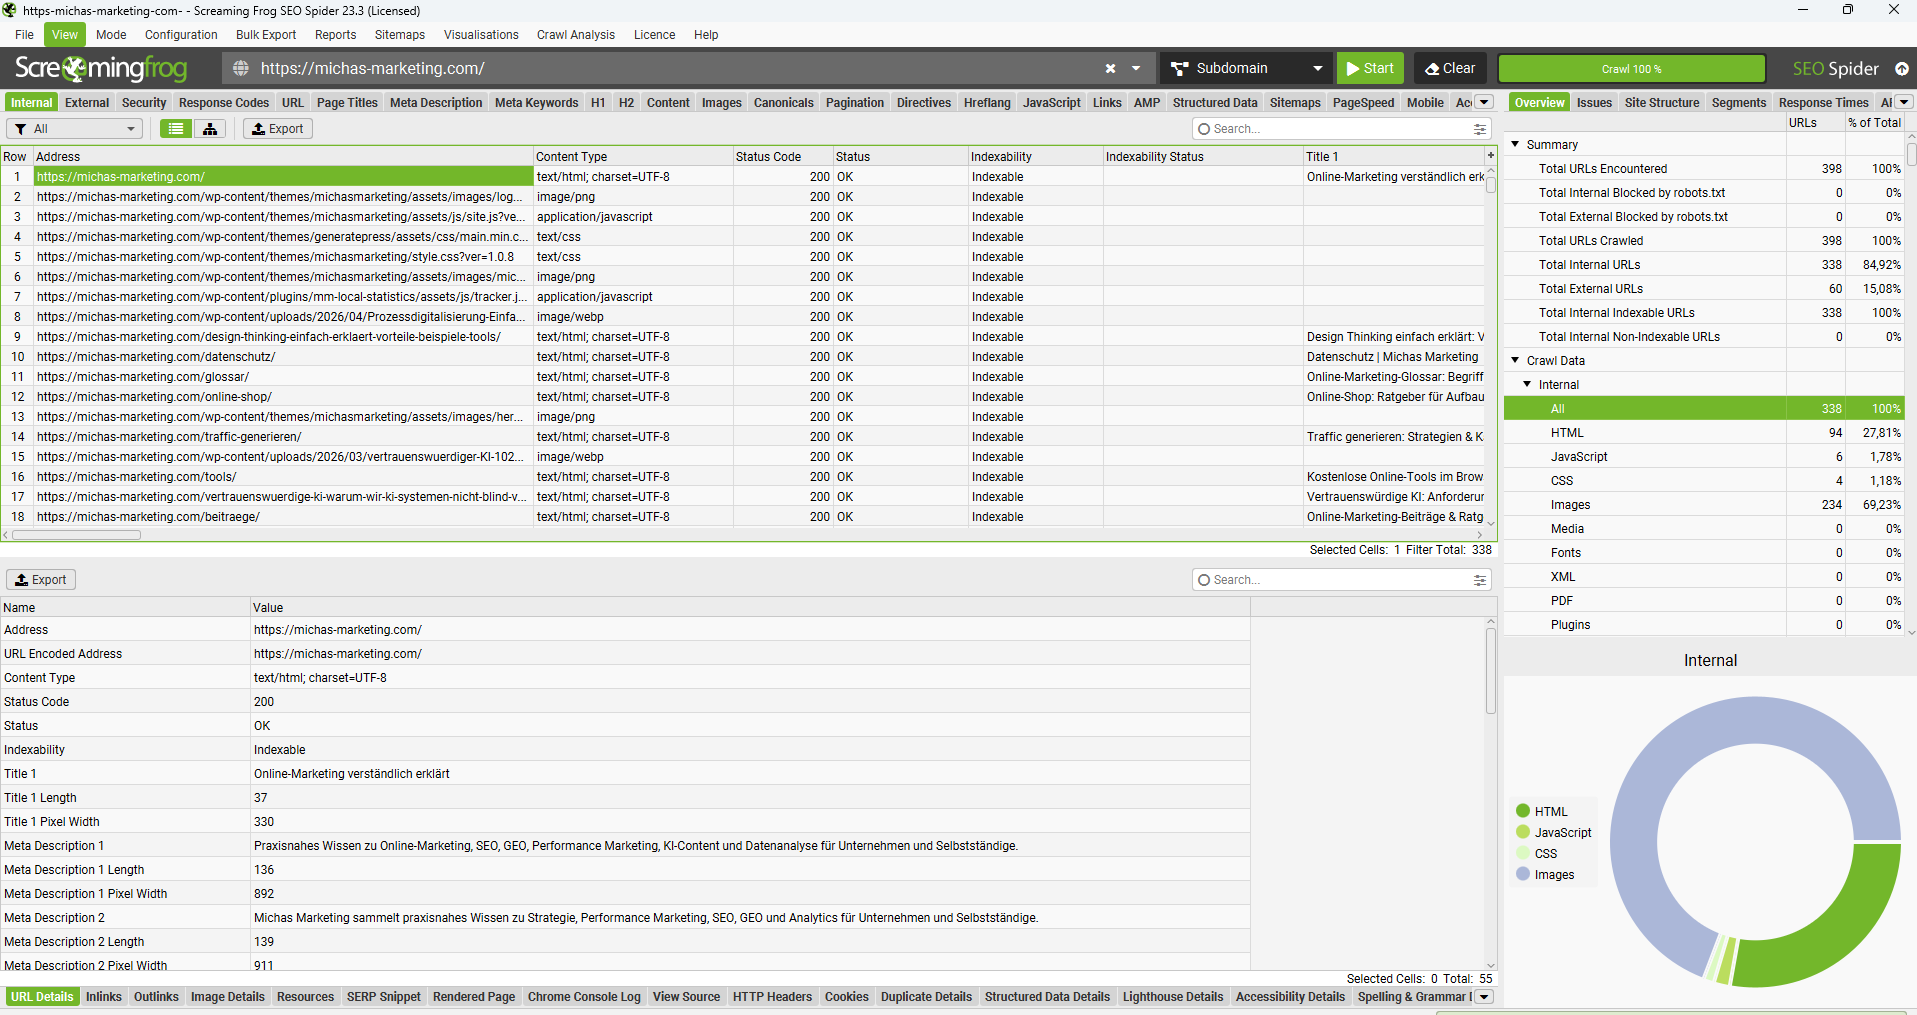
Mit Screaming Frog lassen sich technische SEO-Probleme auf einer Website systematisch aufspüren. Der SEO Spider folgt internen Links ähnlich wie ein Suchmaschinen-Crawler und sammelt dabei unter anderem Statuscodes, Seitentitel, Meta Descriptions, Überschriften, Canonicals, Bilder und strukturierte Daten. So entsteht aus hunderten oder tausenden URLs eine übersichtliche Arbeitsliste.
Ich nutze Screaming Frog regelmäßig für technische SEO-Audits, Relaunch-Kontrollen und schnelle Qualitätschecks. In dieser Anleitung zeige ich, welche Auswertungen besonders nützlich sind, wie du typische Fehler findest und in welcher Reihenfolge du die Ergebnisse bearbeiten solltest.
Was ist Screaming Frog?
Der Screaming Frog SEO Spider ist ein Website-Crawler für Windows, macOS und Linux. Du gibst eine Start-URL ein, startest den Crawl und das Programm folgt den gefundenen Links. Anschließend kannst du technische und inhaltliche SEO-Signale URL für URL prüfen, filtern und exportieren.
Die kostenlose Version eignet sich für kleinere Websites und crawlt bis zu 500 URLs pro Durchlauf. Die kostenpflichtige Lizenz hebt dieses Crawl-Limit auf und schaltet unter anderem erweiterte Konfigurationen, JavaScript-Rendering, Crawl-Vergleiche, Custom Extraction und API-Anbindungen frei. Da Preise und Funktionsumfang geändert werden können, findest du die aktuellen Angaben direkt beim Anbieter.
Screaming Frog im Überblick
| Bereich | Was du damit prüfst | Typische Maßnahme |
|---|---|---|
| Statuscodes | 404-Fehler, 5xx-Fehler, Redirects und Weiterleitungsketten | Links korrigieren und Weiterleitungen bereinigen |
| Snippets | Page Titles und Meta Descriptions | Fehlende, doppelte oder abgeschnittene Angaben überarbeiten |
| Content | H1/H2, Wortanzahl sowie exakte und ähnliche Inhalte | Seiten ausbauen, zusammenlegen oder klarer differenzieren |
| Indexierung | noindex, robots.txt, Canonicals und Sitemaps | Unbeabsichtigte Indexierungssignale korrigieren |
| Interne Links | Crawl-Tiefe, Inlinks, Ankertexte und Link Score | Wichtige Seiten prominenter und direkter verlinken |
| Technik | JavaScript, Core Web Vitals, strukturierte Daten und Sicherheit | Rendering-, Performance- und Markup-Probleme beheben |
Der schnelle Einstieg: Website richtig crawlen
- Programm installieren: Lade den SEO Spider von der offiziellen Website herunter und installiere ihn. Screaming Frog SEO Spider auf der offiziellen Website ansehen
- Start-URL eingeben: Trage die vollständige Adresse deiner Website ein, zum Beispiel
https://www.example.de/. - Crawl starten: Klicke auf „Start“ und warte bei einer vollständigen Prüfung, bis der Fortschritt 100 Prozent erreicht.
- Ergebnisse filtern: Arbeite dich nicht wahllos durch alle URLs. Nutze die Tabs, Filter und den rechten Bereich „Overview“.
- Crawl Analysis ausführen: Starte nach dem Crawl die nachgelagerte Analyse. Erst dann werden unter anderem Link Score, Near Duplicates und bestimmte Orphan-URL-Filter vollständig befüllt.
- Findings priorisieren: Beginne mit Fehlern auf wichtigen, indexierbaren Seiten und nicht automatisch mit dem zahlenmäßig größten Problem.
Wichtig: Prüfe vor größeren Crawls, ob du die Website crawlen darfst. Reduziere bei kleinen oder empfindlichen Servern die Geschwindigkeit unter den Crawl-Einstellungen. Ein aggressiver Crawl kann unnötige Serverlast verursachen.
Quick Wins: Diese Fehler findest du direkt in den Tabs
Statuscodes und defekte Links
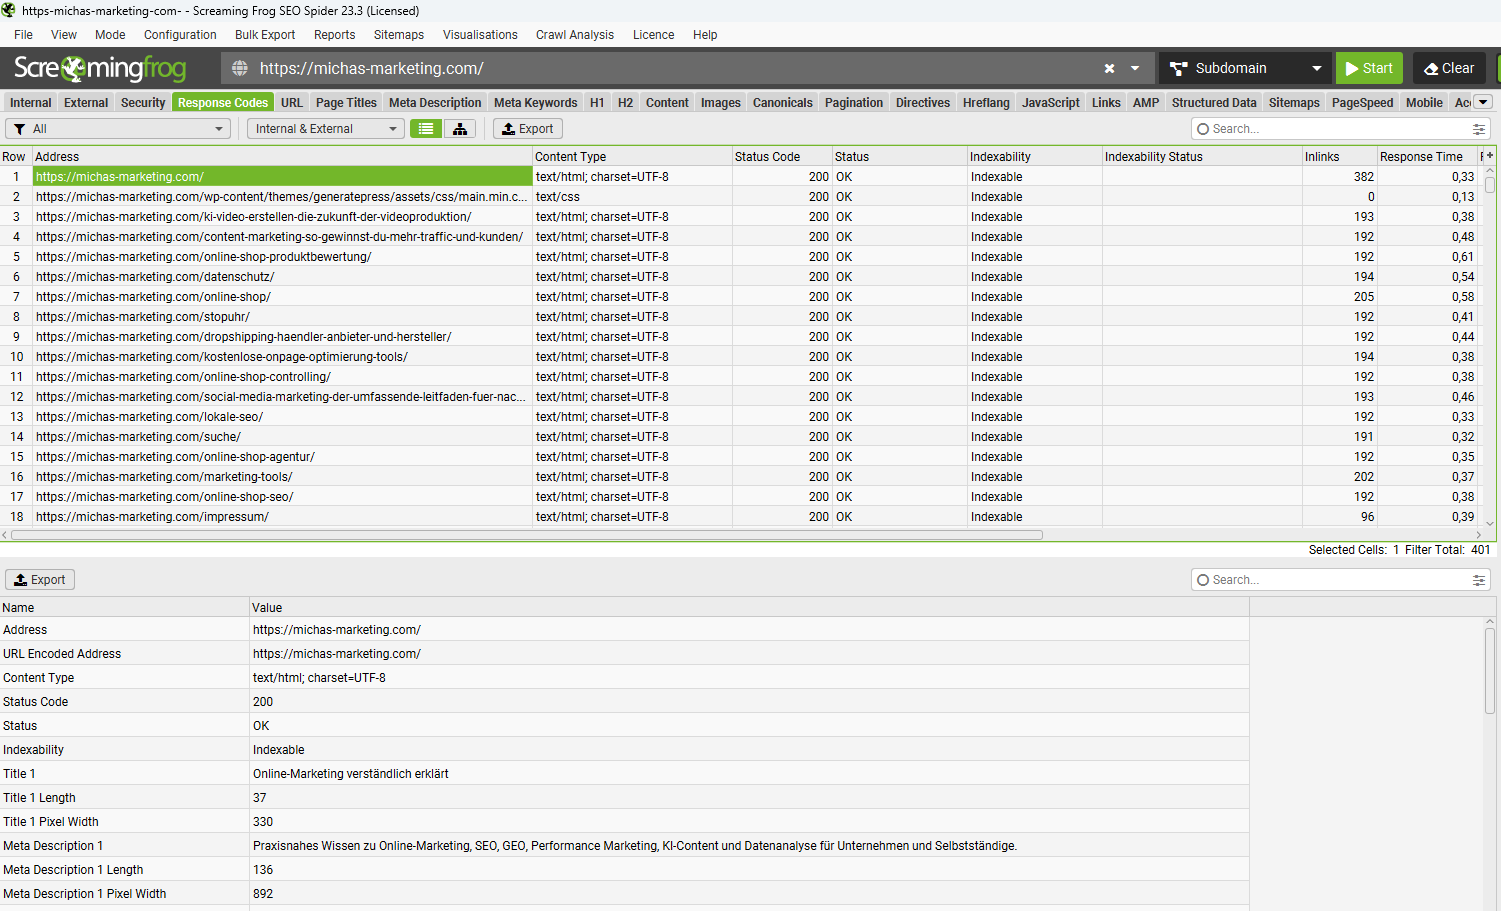
Im Bereich „Response Codes“ findest du URLs mit Weiterleitungen sowie Client- und Serverfehlern. Die wichtigsten Aufgaben:
- Interne 404-Fehler: Wähle die betroffene URL aus und öffne unten den Tab „Inlinks“. Dort siehst du, welche Seite auf die defekte Adresse verlinkt. Korrigiere den Link oder richte bei einem dauerhaft verschobenen Inhalt eine passende 301-Weiterleitung ein.
- Redirect-Ketten und -Loops: Exportiere sie über „Reports“ → „Redirects“ → „Redirect Chains“. Interne Links sollten möglichst direkt auf die endgültige Ziel-URL zeigen.
- Temporäre Weiterleitungen: Prüfe 302- und 307-Redirects. Für dauerhaft verschobene Inhalte ist in der Regel eine permanente Weiterleitung vorgesehen.
- 5xx-Fehler: Übergib wiederkehrende Serverfehler mit URL, Zeitpunkt und Crawl-Einstellungen an die Technik. Einzelne Fehler sollten zur Sicherheit erneut getestet werden.
- Externe defekte Links: Prüfe auch externe Ziele. Entferne veraltete Verweise oder ersetze sie durch eine aktuelle, vertrauenswürdige Quelle.
Page Titles
- Fehlende, doppelte oder mehrfach im Quelltext vorhandene Titles identifizieren.
- Zu lange und zu kurze Titles prüfen. Screaming Frog bewertet dafür neben der Zeichenzahl auch die geschätzte Pixelbreite; diese ist für die mögliche Darstellung in Suchergebnissen aussagekräftiger.
- Titles, die exakt der H1 entsprechen, nicht automatisch als Fehler behandeln. Häufig lässt sich der Title jedoch stärker auf Suchintention und Klickanreiz zuschneiden, während die H1 die Seite klar benennt.
- Boilerplate und abgeschnittene Markennamen kontrollieren, besonders bei automatisch erzeugten Produkt- oder Kategorieseiten.
Die bekannten Pixelgrenzen sind nützliche Warnwerte, aber keine Garantie für eine bestimmte Darstellung. Google kann Suchergebnis-Titel umschreiben und zeigt je nach Gerät und Suchanfrage unterschiedlich viel Text an.
Meta Descriptions
- Fehlende und doppelte Beschreibungen finden, zum Beispiel bei Pagination, Filter-URLs oder kopierten Seitentemplates.
- Sehr lange Descriptions prüfen. Werte oberhalb der im Tool hinterlegten Pixelbreite können in der Vorschau abgeschnitten werden.
- Wichtige Seiten mit einer konkreten Aussage, relevantem Nutzen und einem passenden Handlungsimpuls versehen.
- Descriptions nicht blind für jede unbedeutende URL schreiben. Priorität haben indexierbare Seiten mit Rankings oder realistischem Suchpotenzial.
Überschriften H1 und H2
- Seiten ohne H1, mit mehreren H1 oder mit duplizierten H1 prüfen.
- Mehrere H1 sind in HTML zwar grundsätzlich möglich, in redaktionellen Templates ist eine eindeutige Hauptüberschrift aber meist leichter zu pflegen und zu prüfen.
- Die H2-Struktur auf Verständlichkeit kontrollieren. Fehlende Zwischenüberschriften können auf schlecht gegliederten Content hinweisen.
- Nicht nur Filter abarbeiten: Entscheidend ist, ob die Überschriften den Inhalt sinnvoll strukturieren und Nutzern Orientierung geben.
Bilder
- Unter „Images“ nach fehlenden oder leeren Alt-Attributen filtern. Informative Bilder brauchen eine sinnvolle Textalternative; rein dekorative Bilder dürfen ein leeres Alt-Attribut besitzen.
- Große Bilddateien identifizieren, beispielsweise über „Over 100 KB“. Der Grenzwert ist ein guter Startpunkt, aber kein Qualitätsurteil: Format, Abmessungen und sichtbare Größe müssen mitbewertet werden.
- Überdimensionierte Bilder verkleinern und moderne Formate wie WebP oder AVIF prüfen.
- Fehlende Breiten- und Höhenangaben untersuchen, da reservierter Platz Layout-Verschiebungen reduzieren kann.
- Defekte Bild-URLs und Bilder, die über eine Weiterleitung geladen werden, bereinigen.
Indexierbarkeit und Canonicals prüfen
Indexierbarkeit
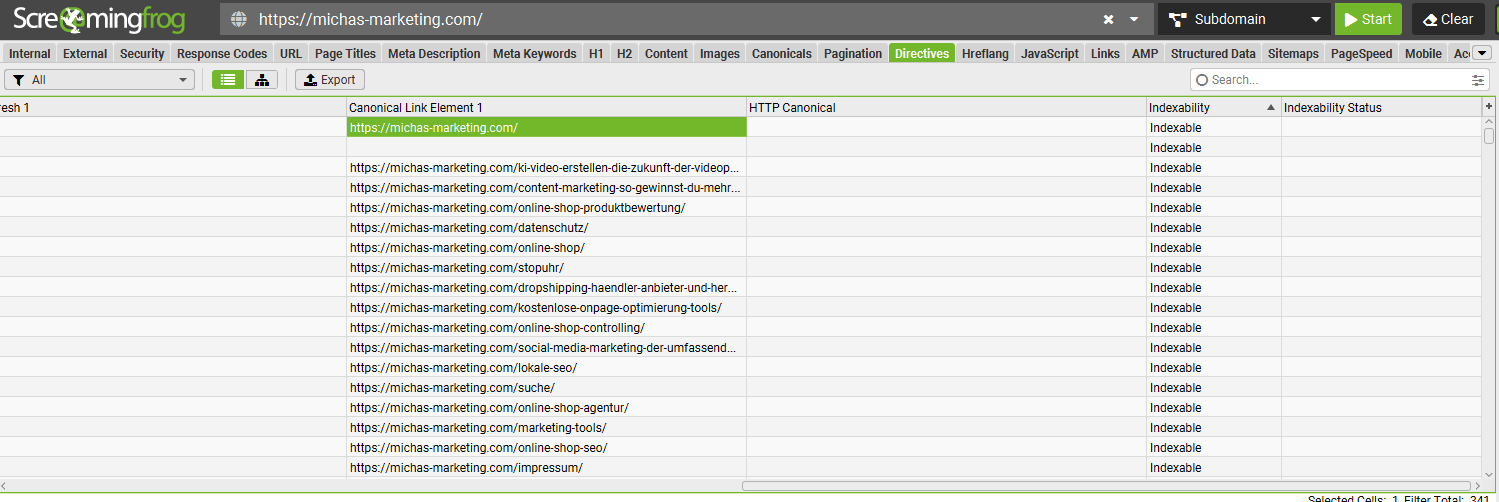
Im Tab „Directives“ und über die Spalten beziehungsweise Filter zur Indexierbarkeit erkennst du, welche URLs auf noindex stehen, durch die robots.txt blockiert sind oder wegen eines Canonicals als nicht indexierbar gelten.
Besonders häufig finde ich zwei gegensätzliche Probleme: Eine wichtige Landingpage ist versehentlich auf noindex gesetzt, während unbedeutende Filter- und Parameter-URLs vollständig indexierbar sind. Bewerte deshalb immer, welche URL betroffen ist und welche Aufgabe sie innerhalb der Website hat.
Canonicals
- Fehlende Canonical-Tags auf indexierbaren HTML-Seiten überprüfen.
- Canonicals finden, die auf Redirects, 404-Seiten, noindex-URLs oder fachlich unpassende Seiten zeigen.
- Widersprüchliche Canonicals aus HTML-Head und HTTP-Header auflösen.
- Canonical-Ketten vermeiden und möglichst direkt auf die bevorzugte, erreichbare 200-URL verweisen.
- Bei paginierten Seiten, Varianten und Parameter-URLs prüfen, ob die Canonical-Strategie wirklich zur gewünschten Indexierung passt.
Ein Canonical ist ein Hinweis an Suchmaschinen und kein Ersatz für eine saubere URL-Struktur. Interne Links, Sitemap-Einträge, Weiterleitungen und Canonicals sollten möglichst dieselbe bevorzugte URL unterstützen.
Interne Verlinkung und Seitenstruktur verbessern
- Crawl-Tiefe: Sortiere die Spalte „Crawl Depth“. Wichtige Seiten sollten mit wenigen Klicks erreichbar sein. Ebene 4 oder tiefer ist ein Prüfsignal, aber nicht pauschal ein Fehler.
- Wenige Inlinks: Identifiziere relevante Seiten mit sehr wenigen internen Links. Ergänze passende kontextuelle Links aus starken, thematisch nahen Seiten.
- Viele Outlinks: Prüfe Templates oder Linklisten mit ungewöhnlich vielen ausgehenden Links. Nicht jeder Link ist problematisch, doch große, unstrukturierte Listen können Fokus und Nutzbarkeit schwächen.
- Ankertexte: Exportiere die internen Ankertexte, zum Beispiel über „Bulk Export“ → „Links“ → „All Anchor Text“. Ersetze nichtssagende Formulierungen wie „hier klicken“ durch verständliche, kontextbezogene Linktexte.
- Link Score: Nutze den internen Link Score als relatives Signal. Eine geschäftlich wichtige Seite mit sehr niedrigem Wert verdient eine manuelle Prüfung.
Orphan Pages finden
Eine verwaiste Seite kann vom normalen Startpunkt des Crawls nicht über interne Links erreicht werden. Damit Screaming Frog solche URLs überhaupt vergleichen kann, braucht das Tool zusätzliche Quellen:
- XML-Sitemap einbinden und/oder Google Search Console beziehungsweise GA4 verbinden.
- Das Crawlen neu entdeckter URLs in der jeweiligen Konfiguration aktivieren.
- Den Website-Crawl vollständig abschließen.
- Anschließend „Crawl Analysis“ starten.
- Die Orphan-URL-Filter unter Sitemaps, Analytics und Search Console auswerten.
Ohne zusätzliche URL-Quelle und nachgelagerte Crawl Analysis bleiben die entsprechenden Filter leer. Prüfe gefundene Seiten manuell: Relevante Inhalte sollten intern verlinkt werden; veraltete oder unerwünschte Seiten benötigen je nach Fall eine Weiterleitung, Entfernung oder klare Indexierungsanweisung.
Thin Content und Duplicate Content
- Wortanzahl sortieren: Seiten mit sehr wenig Text sind Kandidaten für eine Prüfung. Eine feste Grenze wie 300 Wörter ist jedoch kein Ranking-Gesetz. Eine kurze Kontakt-, Produkt- oder Rechnerseite kann ihren Zweck vollständig erfüllen.
- Exakte Duplikate: Gleiche Hash-Werte können auf identische Seitenvarianten hinweisen. Prüfe Weiterleitungen, Canonicals und die interne Verlinkung.
- Near Duplicates: Aktiviere die Speicherung beziehungsweise Analyse des Seiteninhalts vor dem Crawl und führe danach die Crawl Analysis aus. Der standardmäßige Ähnlichkeitsschwellenwert von 90 Prozent lässt sich anpassen.
- Template-Anteile berücksichtigen: Navigation, Footer und wiederkehrende Elemente können den Vergleich beeinflussen. Lege bei Bedarf einen relevanten Content-Bereich für die Analyse fest.
- Suchintention prüfen: Ähnliche Seiten müssen nicht automatisch zusammengelegt werden. Entscheidend ist, ob jede Seite einen eigenständigen Nutzen und eine eigene Suchintention bedient.
Strukturierte Daten kontrollieren
Aktiviere die Extraktion und Validierung strukturierter Daten in der Crawl-Konfiguration. Screaming Frog kann JSON-LD, Microdata und RDFa erfassen und gegen Schema.org beziehungsweise unterstützte Google-Funktionen prüfen.
Achte besonders auf:
- fehlende Pflicht- oder empfohlene Eigenschaften,
- ungültige Werte und Syntaxfehler,
- widersprüchliche Angaben zwischen sichtbarem Inhalt und Markup,
- Seiten eines bestimmten Typs, auf denen das erwartete Markup fehlt,
- Markup, das zwar technisch korrekt ist, aber nicht zum tatsächlichen Seiteninhalt passt.
Eine bestandene Validierung garantiert kein Rich Result. Sie zeigt zunächst nur, dass das Markup die geprüften technischen Anforderungen erfüllt.
API-Anbindungen: Aus Crawldaten werden Prioritäten
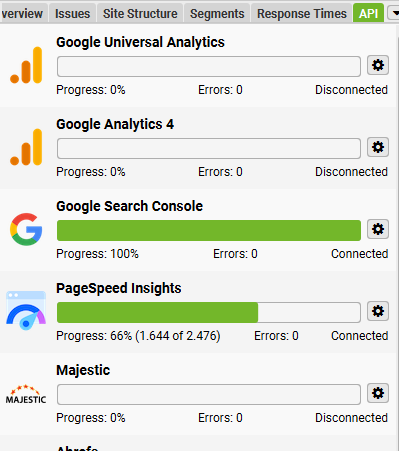
PageSpeed Insights API
Über die PageSpeed-Insights-Anbindung lassen sich Lighthouse-Daten, Performance-Diagnosen und – sofern genügend reale Nutzerdaten vorhanden sind – CrUX- beziehungsweise Core-Web-Vitals-Daten pro URL abrufen. Besonders hilfreich sind Hinweise zu ungenutztem CSS und JavaScript, Bildoptimierung, Render-Blocking und langen Hauptthread-Aufgaben.
Fehlende CrUX-Werte bedeuten nicht automatisch, dass eine Seite schnell oder langsam ist. Bei URLs mit wenig Traffic reicht die Datenmenge häufig nicht für einen eigenen Felddatensatz aus.
Google Search Console und GA4
Nach der Verbindung kannst du Crawl-Daten mit Leistungs- und Nutzungsdaten kombinieren. Dadurch werden aus technischen Listen konkrete Prioritäten:
- Viele Impressionen, aber eine niedrige Klickrate: Title, Description, Suchintention und SERP-Umfeld prüfen.
- Gute Rankings auf der zweiten Ergebnisseite: Inhalt, interne Verlinkung und Snippet gezielt verbessern.
- Indexierbare URLs ohne Impressionen über einen langen Zeitraum: Qualität, Suchnachfrage, Kannibalisierung und Konsolidierung prüfen.
- Seiten mit organischem Traffic, die im normalen Crawl nicht gefunden wurden: mögliche Orphan Pages untersuchen.
- Technische Fehler auf umsatz- oder conversionstarken Seiten zuerst bearbeiten.
„Keine Impressionen“ ist allein noch kein Löschgrund. Saisonale Inhalte, neue URLs, Service-Seiten und Inhalte für bestehende Kunden können auch ohne organischen Traffic sinnvoll sein.
Fortgeschrittene Prüfungen mit Screaming Frog
JavaScript-Rendering
Aktiviere JavaScript-Rendering bei Websites, deren Inhalte und Links clientseitig aufgebaut werden. Vergleiche das rohe mit dem gerenderten HTML. So erkennst du, ob wichtige Texte, Links, Canonicals oder Meta-Daten erst durch JavaScript erscheinen oder sich nach dem Rendering verändern.
Custom Extraction
Mit XPath, CSS-Selektoren oder regulären Ausdrücken kannst du individuelle Werte auslesen. Beispiele:
- Produktpreise und Verfügbarkeit,
- Autor, Veröffentlichungs- und Aktualisierungsdatum,
- Tracking- oder Consent-Code,
- Open-Graph- und Social-Media-Tags,
- Artikelnummern, Bewertungen oder spezielle Markup-Felder.
Custom Search
Durchsuche den Quelltext nach Platzhaltern und unerwünschten Resten, zum Beispiel „Lorem ipsum“, alten Telefonnummern, Test-Domains, veralteten Tracking-IDs oder bestimmten Plugin-Ausgaben. Nutze die Suche auch positiv: So lässt sich prüfen, auf welchen Templates ein erwarteter Code fehlt.
Rechtschreibung und Grammatik
Stelle die Sprache auf Deutsch und nutze die Prüfungen unter „Content“. Eigennamen, Fachbegriffe und zusammengesetzte Wörter erzeugen gelegentlich Fehlalarme; deshalb sollten Vorschläge redaktionell geprüft und nicht ungefiltert übernommen werden.
Hreflang
Bei internationalen Websites findest du unter anderem fehlende Rückverweise, ungültige Sprach- oder Ländercodes, nicht indexierbare Zielseiten und hreflang-Ziele mit einem Statuscode ungleich 200. Kontrolliere zusätzlich, ob alle Varianten aufeinander verweisen und eine passende Standardversion über x-default sinnvoll ist.
Sitemap-Abgleich
Vergleiche die XML-Sitemap mit dem normalen Site-Crawl. So findest du URLs in der Sitemap, die weiterleiten, einen Fehler liefern, auf noindex stehen oder nicht intern verlinkt sind. Umgekehrt erkennst du indexierbare Seiten, die in der Sitemap fehlen.
Sicherheit und Barrierefreiheit
Ergänzend lohnt sich ein Blick auf unsichere Inhalte, Mixed Content, unsichere Formulare und fehlende Sicherheitsheader. Die integrierte Accessibility-Prüfung kann außerdem automatisiert auf zahlreiche WCAG-bezogene Probleme hinweisen. Solche automatischen Tests sind nützlich, ersetzen aber keine manuelle Prüfung mit Tastatur und Screenreader.
Crawls vergleichen
Mit Crawl Comparison kannst du nachvollziehen, welche Fehler neu hinzugekommen oder verschwunden sind. Das ist besonders nach einem Relaunch, einer Migration, einem Template-Update oder größeren Content-Änderungen wertvoll. Vergleiche dabei nicht nur die Fehleranzahl, sondern auch Statuscodes, Indexierbarkeit, Canonicals, Titles und interne Verlinkung wichtiger URLs.
SEO-Probleme sinnvoll priorisieren
Die Anzahl der gefundenen URLs ist selten die beste Sortierung. 500 unwichtige Filter-URLs ohne individuelle Meta Description können weniger dringend sein als eine zentrale Kategorieseite, die auf noindex steht oder nur auf Crawl-Tiefe 5 erreichbar ist.
| Priorität | Typische Fälle | Warum zuerst? |
|---|---|---|
| Sehr hoch | Wichtige Seiten mit noindex, 5xx, falschem Canonical oder versehentlicher robots.txt-Blockade | Die Seite kann möglicherweise nicht zuverlässig gecrawlt oder indexiert werden |
| Hoch | Interne 404er, Redirect-Ketten, Orphan Pages und schwache interne Verlinkung wichtiger URLs | Nutzerführung, Crawlbarkeit und interne Signale leiden |
| Mittel | Doppelte Titles, schwache Descriptions, große Bilder und dünne Inhalte mit Suchpotenzial | Optimierung kann Sichtbarkeit, Klickrate und Nutzererlebnis verbessern |
| Niedriger | Formale Warnungen auf unwichtigen oder bewusst nicht indexierbaren URLs | Geringer erwarteter Effekt; häufig reicht Beobachtung oder Template-Bereinigung |
Ich priorisiere Findings anhand von vier Fragen:
- Ist die URL indexierbar und soll sie organisch gefunden werden?
- Wie wichtig ist sie für Traffic, Leads oder Umsatz?
- Wie groß ist der mögliche Schaden beziehungsweise Nutzen?
- Lässt sich das Problem einmalig im Template lösen oder muss jede URL einzeln bearbeitet werden?
Empfohlener Workflow nach jedem Crawl
- Crawl vollständig abschließen und auffällige Ausfälle gegebenenfalls nachtesten.
- „Crawl Analysis“ ausführen, damit Orphan Pages, Near Duplicates und Link Score verfügbar sind.
- Über „Reports“ → „Crawl Overview“ einen Gesamtüberblick exportieren.
- Ergebnisse nach Seitentyp segmentieren, zum Beispiel Produkte, Kategorien, Ratgeber und Systemseiten.
- Mit Search-Console-, Analytics- und Geschäftsdaten anreichern.
- Aufgaben nach Wirkung und Aufwand priorisieren.
- Nach der Umsetzung erneut crawlen und die Änderung verifizieren.
- Bei regelmäßigen Audits Konfiguration speichern und Crawls vergleichen, damit die Ergebnisse reproduzierbar bleiben.
Mein Praxistipp: Dokumentiere nicht nur den Fehler, sondern auch Beispiel-URL, Seitentyp, Ursache, empfohlene Lösung, Verantwortlichkeit und Prüfkriterium. Aus einem großen Export wird so ein umsetzbarer SEO-Plan.
Vorteile und Grenzen
| Vorteile | Grenzen |
|---|---|
| Sehr viele technische Signale in einem Crawl | Das Tool bewertet nicht automatisch die geschäftliche Bedeutung einer Seite |
| Flexible Filter, Exporte und individuelle Extraktionen | Warnungen sind Prüfsignale und nicht immer echte Fehler |
| API-Daten lassen sich URL-genau ergänzen | Große Websites benötigen ausreichenden Arbeitsspeicher oder Datenbankspeicherung |
| Geeignet für Audits, Migrationen und Qualitätskontrollen | Ein Crawl zeigt primär den technisch erreichbaren Zustand zum Prüfzeitpunkt |
| Kleine Websites können kostenlos geprüft werden | Viele fortgeschrittene Funktionen benötigen eine kostenpflichtige Lizenz |
Fazit: Screaming Frog macht aus einer Website eine prüfbare Datenbasis
Screaming Frog ist besonders stark, wenn du nicht nur einzelne Seiten, sondern eine komplette Website systematisch untersuchen möchtest. Schon die Standard-Tabs liefern schnelle Erfolge bei defekten Links, Redirects, Titles, Descriptions, Überschriften und Bildern. Mit Crawl Analysis, JavaScript-Rendering und den API-Anbindungen wird daraus ein umfassendes Werkzeug für technische Audits und Content-Entscheidungen.
Der größte Nutzen entsteht nicht durch möglichst viele Exporte, sondern durch eine saubere Priorisierung: zuerst wichtige Seiten mit Indexierungs- oder Erreichbarkeitsproblemen, danach Struktur, Snippets, Content und Performance. Nach der Umsetzung sollte ein Kontroll-Crawl bestätigen, dass die Ursache tatsächlich behoben wurde.
Häufige Fragen zu Screaming Frog
Ist Screaming Frog kostenlos?
Ja. Die kostenlose Version des SEO Spider crawlt bis zu 500 URLs pro Durchlauf und enthält wichtige Basisfunktionen. Für unbegrenzte Crawls sowie viele erweiterte Konfigurationen, Integrationen und Analysen ist eine kostenpflichtige Jahreslizenz erforderlich.
Was bedeutet das Limit von 500 URLs?
Gezählt werden nicht nur sichtbare HTML-Seiten. Je nach Konfiguration kann der Crawl auch Bilder, CSS- und JavaScript-Dateien, Weiterleitungs-URLs, Parameter-URLs und weitere Ressourcen erfassen. Deshalb kann das Limit auch bei einer scheinbar kleinen Website erreicht werden.
Ist Screaming Frog auch für Anfänger geeignet?
Der erste Crawl ist einfach gestartet, die Menge an Daten kann anfangs aber überwältigend wirken. Anfänger sollten mit Response Codes, Page Titles, Meta Descriptions, H1, Images und dem Overview-Bereich beginnen. Wichtig ist, Warnungen nicht ungeprüft als Fehler zu behandeln.
Kann Screaming Frog sehen, welche Seiten bei Google indexiert sind?
Der normale Crawl zeigt, ob eine URL aus technischer Sicht indexierbar erscheint. Ob Google sie tatsächlich indexiert hat, ist eine andere Frage. Über die Search-Console-Integration und optional die URL-Inspection-API lassen sich zusätzliche Indexierungsdaten abrufen; dabei gelten die von Google vorgegebenen Kontingente.
Warum findet Screaming Frog nicht alle Seiten?
Mögliche Ursachen sind fehlende interne Links, robots.txt-Regeln, Login-Bereiche, nicht crawlbare JavaScript-Navigation oder eine unpassende Konfiguration. Binde XML-Sitemap, Search Console oder Analytics als zusätzliche Quellen ein, wenn du auch verwaiste URLs finden möchtest.
Warum bleiben die Filter für Orphan Pages oder Near Duplicates leer?
Für Orphan Pages benötigt Screaming Frog eine zusätzliche URL-Quelle wie Sitemap, Search Console oder Analytics. Near Duplicates müssen vor dem Crawl aktiviert werden. In beiden Fällen ist nach dem abgeschlossenen Crawl eine „Crawl Analysis“ erforderlich.
Kann Screaming Frog JavaScript-Websites crawlen?
Ja, in der Lizenzversion kann der SEO Spider Seiten mit dem integrierten Chromium-Renderer verarbeiten. Das ist unter anderem bei React-, Vue- oder Angular-Anwendungen hilfreich. Vergleiche gerendertes und ursprüngliches HTML, um JavaScript-Abhängigkeiten zu erkennen.
Wie oft sollte ich eine Website crawlen?
Das hängt von Größe und Änderungsfrequenz ab. Nach Relaunches, Migrationen und größeren Template-Änderungen ist ein Crawl Pflicht. Für laufende Websites kann ein monatlicher oder vierteljährlicher Audit sinnvoll sein; sehr dynamische Shops und Portale profitieren oft von kürzeren Abständen.
Verändert Screaming Frog meine Website?
Ein normaler Crawl liest öffentlich erreichbare Inhalte und verändert sie nicht. Er erzeugt jedoch Anfragen an den Server. Crawl-Geschwindigkeit, Rendering, URL-Anzahl und sensible Funktionen wie Formulare sollten deshalb verantwortungsvoll konfiguriert werden.